この記事のポイント
- H-JEPAは遠い目標と直近の行動を分けて計画する研究。上位の計画から、下位の層へ中間目標を渡します。
- 模擬環境Visual AntMazeでは、比較手法の18%に対し3段構成で成功率73%と研究チームが報告しました。
- 物体を押す課題では深い構成で性能が低下。作業の長さや学習記録に合う階層を考えるための結果です。
LeCun氏らのH-JEPAの論文・プロジェクトページをもとに、計画の階層分けを紹介します。改善した課題と、効果が限られた課題を分けて整理します。
遠い目標を中間目標へ分け、最後に具体的な行動へ
H-JEPAは、研究チームが公開した論文・プロジェクトページ(著者はLeCun氏ら5名、所属はAdvanced Machine IntelligenceやNYUなど)で示された、環境の変化や次の状態を予測する「世界モデル」です。ベースはLeCun氏が以前から提唱する「JEPA」という方式で、ひとことで言うと、映像そのものではなく「これから何が起きそうか」をAIが扱いやすい特徴の表現で予測させる学習法です。
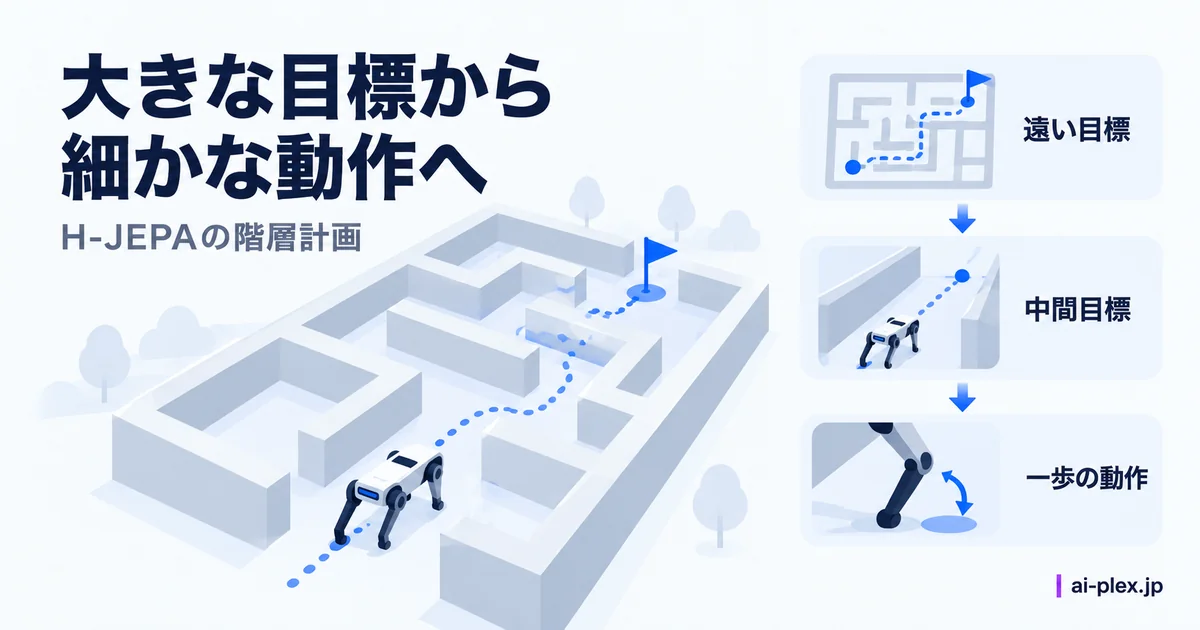
従来のJEPA型世界モデルは、遠い先の大まかな見通しも直後の細かい動きも、同じ1つの仕組みで担っていました。H-JEPAはここを分け、複数の階層を用意します。上の階層ほど遠い未来をそれぞれ専用の特徴表現で予測し、その予測が一段下への「とりあえずの目標」として渡され、最後の最下層が実際の行動を作ります。
模擬迷路では3段構成の成功率が73%、比較手法は18%
研究チームはコンピューター上の4種類の模擬環境で検証しており、カメラ画像をもとに迷路を脱出する「Visual AntMaze」では、1段構成の比較手法「LeWM」に対し、3段の階層を持たせたH-JEPAで成功率が18%から73%まで上がったと報告されています。計画を立てる際の計算量も抑えられたとのことです。
実際のロボットアームの映像データセット「DROID」でも、過去の映像から計画の精度をオフラインで評価する検証を実施。「このあとどう動くべきか」を逆算して学習させる工夫を加えると、計画の忠実度が上がり計算量も減ったと説明されています。これは動作の軌跡が手本にどれだけ近いかを測った評価で、実機で作業を完遂できる割合とは異なります。いずれも研究チームによる報告です。
階層を増やせば、どの作業でも良くなるわけではない
公式ページでは、物体を押す「Push-T」の課題は2段構成で比較手法と同等以上だった一方、より深い構成では性能が下がったと報告しています。短い動作記録では、長い時間幅を学ぶためのデータが少なくなる可能性が理由として挙げられています。
ロボットの動作計画を検討している方にとっては、遠い目標と目の前の動作を分ける設計が参考になります。比較するときは、作業の長さと、学習に使える動作記録が実験条件に近いかが確認点になります。
まとめ:作業の長さと記録データに合う計画を考える
H-JEPAは、大まかな目標を下の階層へ渡し、細かな行動へ落とし込む世界モデルの研究です。基礎的な位置づけは、フィジカルAIとは何かで整理しています。
今回の判断材料は、計画の階層分けで改善した課題と、深くしても改善しなかった課題があることです。実務への応用を考える場合は、作業の長さや記録データの性質が実験条件とどう違うかを見比べると、研究結果の適用範囲を捉えやすくなるでしょう。
