この記事のポイント
- EmbeddingGemma 2は文章・画像・動画・音声を共通の数字の座標へ変換。意味の近い情報を探す検索を支えます。
- モデル規模はフル構成で7億4,000万、文章のみなら2億7,000万パラメータ。扱うデータに応じて構成を選べます。
- 検索用の変換処理は自社環境に置けます。回答を作るモデルと、誰に文書を見せるかは別に設計する必要があります。
Googleの2026年10月6日の発表から、検索を支える変換モデルを紹介します。検索・回答・閲覧権限を切り分け、自社環境で扱う範囲を整理します。
文章・画像・音声を同じ「意味の地図」で検索できる
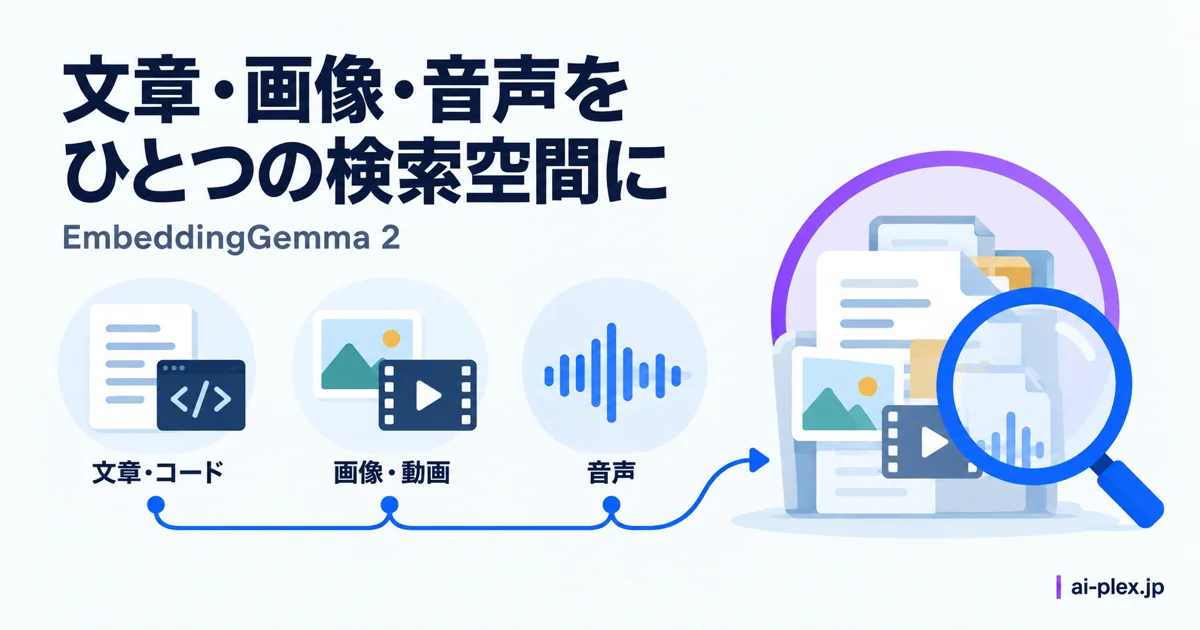
文章だけでなく画像や音声も扱う検索用モデル「EmbeddingGemma 2」が発表されました(Google公式ブログ)。
埋め込み(エンベディング)モデルとは、ひとことで言うと、文章や画像を「意味の近さ」で並べ替えられる数字の座標に変換する仕組みです。似た内容ほど座標上で近くに置かれます。関連文書を検索して回答作成に使う仕組み(RAG、検索拡張生成)でも、検索部分を支える技術です。
EmbeddingGemma 2は、この地図をテキストだけでなくコード・画像・動画・音声までまとめて1つの空間に収められるのが特徴です。モデルを構成する数値(パラメータ)の数はフル構成で7億4,000万、テキストのみなら2億7,000万です。文章だけを扱う場合は、画像・音声用の部品を読み込まずに使えます。
ライセンスは商用利用も可能なApache 2.0で、学習済みのモデルデータ(重み)はHugging FaceとKaggleから入手できます。Ollama・llama.cpp・vLLMなどの実行ツールに対応しています。必要なメモリや処理時間は、構成と実行環境によって異なります。
社内検索を自社環境で運用するなら、回答部分も切り分ける
クラウドの埋め込みAPIを使う方式に対し、自社環境でモデルを動かす方式では検索用の変換処理を手元に置けます。回答を作るモデルは別に組み合わせます。外部送信なしのRAGにするには、回答用モデルなど後段の処理も自社環境に収める必要があります。
社内の誰がどの文書を閲覧できるかは、別途管理します。社内検索を設計する際は、変換・検索・回答の各処理と、検索結果の閲覧権限を切り分けると、管理が必要な範囲を整理できます。
まとめ: 検索品質とデータの扱いを分けて判断する
社内検索の検証では、機密度の低い日本語のマニュアルやFAQと、実際に寄せられる質問を組み合わせるとよいでしょう。必要な資料を探せたかに加え、扱うデータが文章だけの場合と画像・音声を含む場合で、必要なメモリや処理時間を記録する方法が考えられます。
環境の準備にはOllamaで始めるローカルLLM入門、回答用モデルの比較には目的別Ollamaモデルの選び方も参考になります。
検索に失敗した質問と実行負荷は、対象文書や構成を見直す材料になります。機密文書へ広げるかを判断する際は、検索精度だけでなく、セキュリティ担当と閲覧権限や外部通信の有無を確認するとよいでしょう。
