この記事のポイント
- Claude Skillsは作業手順や参照資料をまとめて再利用する仕組みです。
- 起動時は名前と説明だけを読み、必要になったSkillの指示・資料を後から読みます。
- Skillに実行コードを含められるため、提供元や内容を確認してから使います。
Anthropicの公式資料から、Skillsの段階的な読み込みを紹介します。常時参照する情報と、必要時だけ使う資料の役割を整理します。
そもそもAgent Skillsとは
Agent Skillsは、Claudeに特定分野の手順・ベストプラクティス・参考資料をパッケージ化して渡す仕組みです。毎回同じ指示をプロンプトに書く代わりにSkillとして用意しておけば、関連タスクのときだけClaudeが自動で読み込んで使ってくれます。Skillsの整理・診断ツール「skill-doctor」を以前紹介しましたが、今回はその前提となる「どうやって読み込みの負荷を抑えるのか」という仕組み側の話です。
3段階で読み込まれる「段階的読み込み」
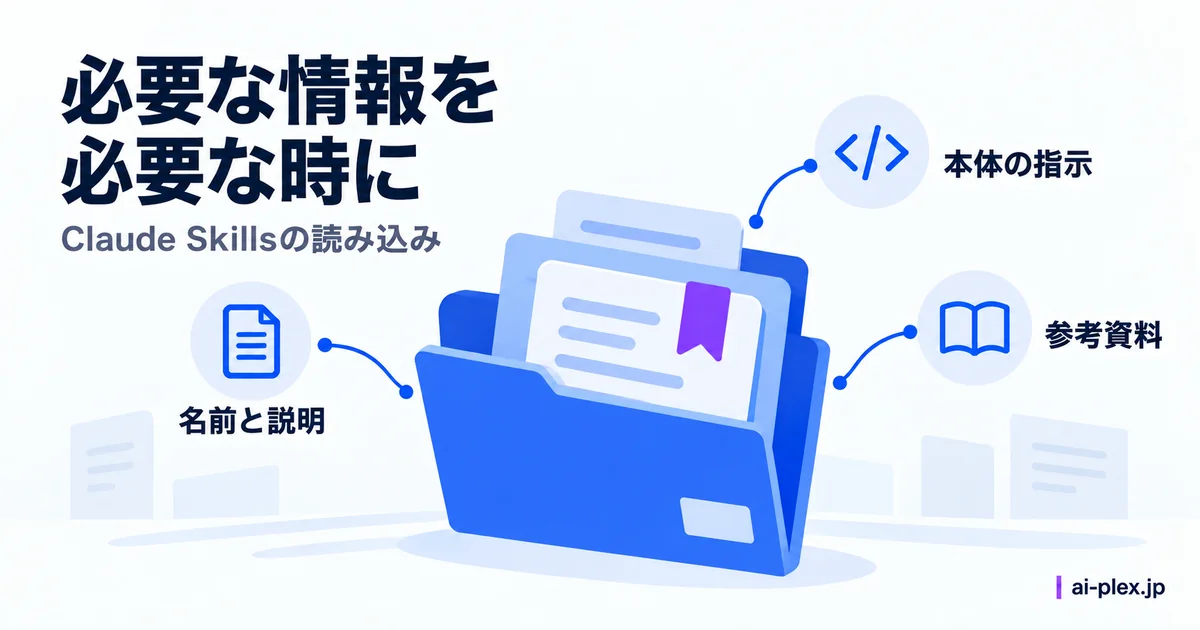
公式ドキュメントによると、Skillsはファイルシステム上のディレクトリとして存在しており、内容に応じて3段階(レベル)で読み込むタイミングが分かれています。これが「段階的読み込み(progressive disclosure)」です。
| レベル | 読み込むタイミング | コスト目安 | 内容 |
|---|---|---|---|
| レベル1: メタデータ | 常時(起動時) | Skillあたり約100トークン | 名前と説明文(YAMLのname・description) |
| レベル2: 本体の指示 | Skillが発動したとき | 5,000トークン未満 | SKILL.mdの本文(手順・ガイダンス) |
| レベル3: 付随ファイル・スクリプト | 必要になったときだけ | アクセスするまでゼロ | 追加の参考資料・実行スクリプト |
ポイントは、常にシステムプロンプトに載っているのはレベル1の「名前と説明文」だけで、本体の指示はそのSkillが実際に使われると判断されたときにだけ読み込まれることです。公式ドキュメントは「このライトウェイトな仕組みのおかげで、本体をすべて事前読み込みせず、多数のSkillsを用意できる」と説明しています。
PDF処理Skillで見る、実際の読み込みの流れ
公式ドキュメントでは、PDF処理用のSkillを例に流れが示されています。起動時は「pdf-processing: PDFファイルからテキストや表を抽出、フォーム入力、ドキュメント結合を行う」という説明文だけが載り、ユーザーが「このPDFのテキストを抽出して要約して」と依頼すると、ClaudeがbashコマンドでSKILL.mdを読み込んで初めて指示がコンテキストに入ります。フォーム入力が不要ならFORMS.mdは読み込まれません。実行スクリプトも同様で、実行してもコード自体はコンテキストに入らず、実行結果だけが消費されます。
使っていないSkillsも名前と説明文は常時読み込まれます。追加しても速度やコストが変わらないという保証ではありません。
まとめ:読み込む情報とSkillの安全性を確認
Skillsを整備する方は、常時読む説明と必要時に読む資料を分けるとよいでしょう。段階的に読む仕組みでも、登録数に応じた説明文と保守の負担は残ります。名前と説明が用途に合っているか、重複や古い手順がないかを確認することが管理の手掛かりになります。
※本記事は2026年9月20日時点の情報です。最新情報はAnthropic公式ドキュメント「Agent Skills」を確認するとよいでしょう。
Agent Skillsの仕組み自体も発展を続けており、Anthropicがこの規格を中立団体へ寄贈した動きも報告されています。
