この記事のポイント
- Sonnet 5.5は入力2ドル・出力10ドル/100万トークンを据え置き。前モデルより複数の評価で成績を伸ばしました。
- 同じ作業の実行コストはAnthropicのテストで最大30%減。単価だけでなく、処理に使うトークン数の違いも関係します。
- APIで従来thinkingを無効にしていた場合はbetween_toolsへの変更が必要。移行前に設定を確認します。
Anthropicの公式発表から、Sonnetの性能と費用の比較を紹介します。モデル単価、消費量、移行時の設定を分けて整理します。
コード作業・知識業務・画面操作の評価が向上
Anthropic公式発表によると、Sonnet 5.5は複数の評価で前モデルのSonnet 5から大きく数値を伸ばしています。特にTerminal-Bench 4.0(文字で命令を入力する画面を使い、AIが開発作業を進める評価)は10.3%から70.6%へ、60.3ポイント上昇しています。知識作業を測るGDPval-AA v2.1も1449から1844に、コンピュータ操作全般を測るOSWorld 2.1も57.0%から80.1%に向上しました。OSWorldの数値は公式表の「partial」条件に対応します。
| 評価項目 | Sonnet 5 | Sonnet 5.5 |
|---|---|---|
| Terminal-Bench 4.0 | 10.3% | 70.6% |
| GDPval-AA v2.1 | 1449 | 1844 |
| CursorBench 4.0 | 34.1% | 55.5% |
| OSWorld 2.1 | 57.0% | 80.1% |
数値はそれぞれ異なる課題・条件での成績です。自社の作業に近い評価から見ると、比較したい用途を絞れます。
価格はそのまま、処理コストは最大30%減
単価は入力トークンが100万あたり2ドル、出力トークンが10ドル、一度送った入力を再利用するキャッシュ読み込みが0.10ドルです。入力・出力単価はSonnet 5と同じで、キャッシュ読み込みは半額です。それでいて出力の生成速度は30%以上速くなり、同じ作業を終えるのに必要なトークン数も減る傾向があるため、単価×トークン数で決まる実行コストは最大30%減るとAnthropicは説明しています。
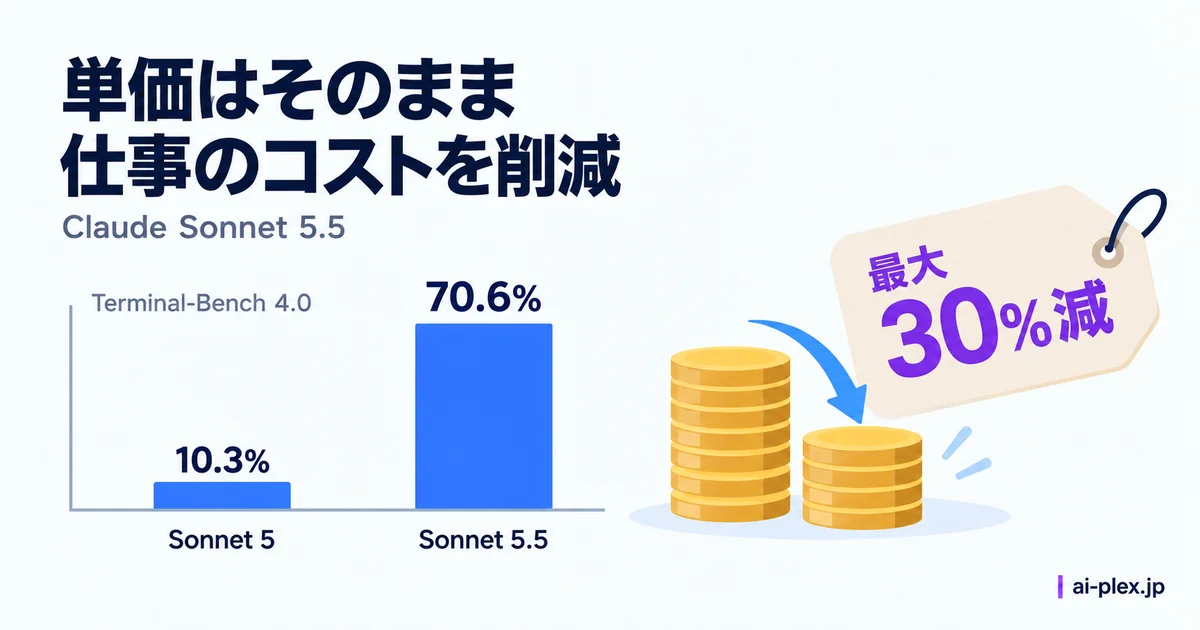
AIが考える深さの設定によっても、速度・消費トークン・品質は変わります。最大30%減という公表値と、自社の作業で測る費用は分けて比較するとよいでしょう。
Sonnet 5.5はClaude Platform・Claude apps・AWS・Google Cloud・Microsoft Azureで利用可能です。APIのモデルIDはclaude-sonnet-5-5。従来、回答前に考える処理(thinking)を無効にしていた場合、移行前にbetween_tools設定への変更が必要です。
まとめ: 移行条件を確認して効果を試す
モデルの利用条件を比較する際はClaude Opus 5.5の発表記事も参考になります。
Sonnet 5.5を比較する場合は、同じ入力で品質・時間・トークン数を測るとよいでしょう。最大3割減という公表値をそのまま自社の削減見込みにせず、再試行や人の修正も含めて評価する方法が考えられます。移行設定と要求品質の両方を確認した用途が、切り替えの検討対象になります。
※ 2026年9月28日時点のAnthropic公式発表に基づいています。
