この記事のポイント
- DeepSeek V4.1 Flashは画像も扱う552BパラメータのMoEモデルです。
- 処理時に使うパラメータは一部ですが、保存容量や必要メモリまで小さいとは限りません。
- 重みはMITライセンスで公開され、10月にはFlash-1017へ更新。評価と実行費用は条件別に確認しましょう。
公式モデルカードから、公開モデルの構成と利用条件を紹介します。モデル全体の規模、計算量、評価結果の条件を分けて整理します。
DeepSeek V4.1 Flashのモデル構成と必要資源
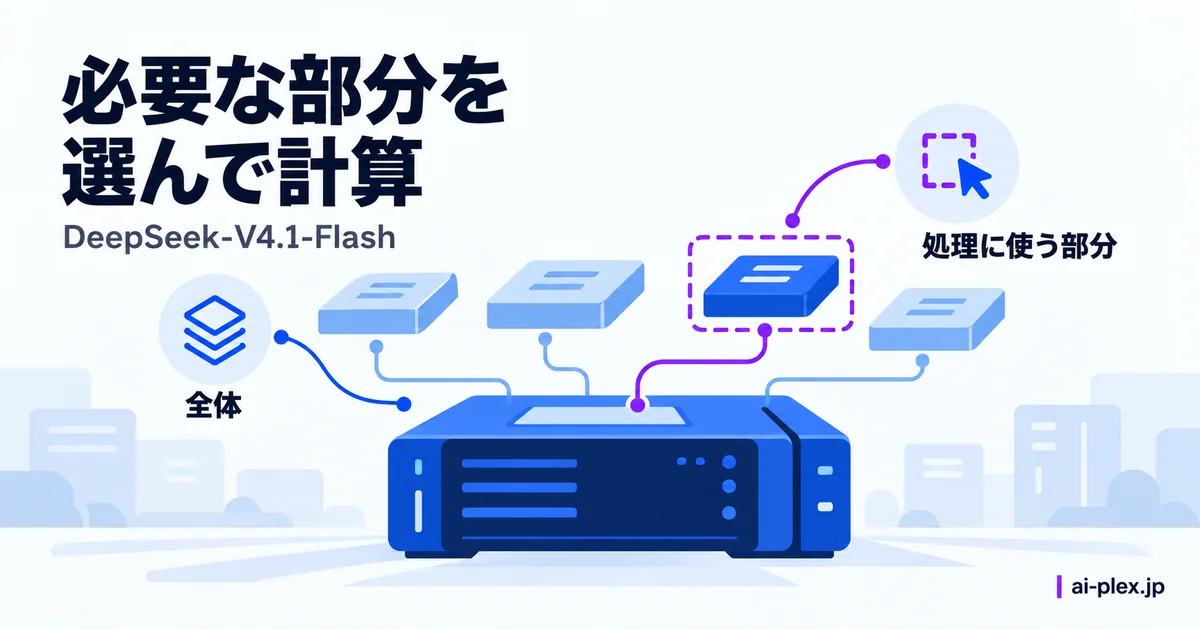
DeepSeek-V4.1-Flashは、画像とテキストを扱うMoE(Mixture-of-Experts、ひとことで言うと「専門家の一部だけを毎回選んで動かす仕組み」)モデルです。モデルカードによると、バックボーンのパラメータ数は552B(5,520億)である一方、実際に1トークンの処理で使われる活性化パラメータは、プリフィル(入力の読み込み)時で8B、デコード(出力の生成)時で16Bにとどまります。全体は大きくても、動かすたびに使う部分は一部だけという設計です。
構造は入力と出力を分けて処理するCausal Encoder-Decoder(CED)です。共有エキスパートに加え、384個の専門部分からトークンごとに6個を選びます。
画像も読める:ネイティブなマルチモーダル対応
V4.1 Flashはテキストと画像を扱い、最大100万トークンの文脈に対応します。長文を一度に扱える長さを示す値であり、実行速度や必要メモリを保証するものではありません。
ベンチマークスコアとライセンス
開発元のモデルカードが報告するスコアです。推論・コーディング・エージェント系はInstructモデルの最大推論努力時、末尾のマルチモーダル2項目はBaseモデルの評価で、同一条件ではありません。
| 分野 | ベンチマーク | スコア |
|---|---|---|
| 推論 | GPQA Diamond | 90.9 |
| コーディング | Codeforces評価 | 3471 |
| エージェント系 | Terminal-Bench 2.1 | 90.6 |
| エージェント系 | DeepSWE v1.1 | 74.2 |
| マルチモーダル | MMMU-Pro | 56.5 |
| マルチモーダル | CVBench | 77.9 |
活性化パラメータ数が小さいことは、モデル全体の保存容量や必要メモリが小さいことを意味しません。開発元の評価値であり、実際の性能は推論設定や実行環境で変わります。ライセンスはMITで、商用利用を含めて比較的自由に扱えます。モデルの重みはHugging Face上で配布されており、重みの公開とAPIの利用料金は別です。実行には対応環境と計算資源が必要です。
出典・参考資料:Hugging Face上の公式モデルカード。
まとめ:モデルの規模・利用条件・実コストを分けて確認
モデルを自社環境で動かす方は、重みの配布条件と必要な計算資源を確認するとよいでしょう。API料金や運用費も含めて試験し、推論設定をそろえたうえで対象業務に合うかを比べられます。
同じく重みが無料で使えるモデルとしては、中国ZhipuがGLM-5.3の重みを公開しています。XiaomiのMiMo-V2.6-Proも評価機関のAI指標で1位を記録したと発表されました。
10月には同モデルの更新版として、コーディング面を強化した新版「V4.1-Flash-1017」も公開されています。
