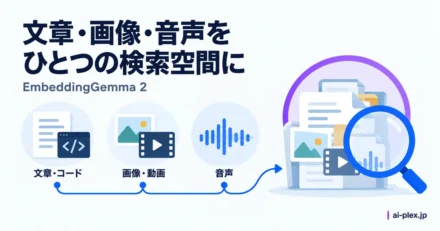
EmbeddingGemma 2公開、テキスト・画像・音声を1つの検索空間に
Googleが軽量な埋め込みモデル「EmbeddingGemma 2」を公開。社内RAGを自社サーバーで動かす選択肢を解説します。
「ローカルLLMって実際どう始めればいいの?」という初歩から丁寧に。必要なスペック、最初の1モデル、セットアップまで、前提知識ゼロで読める入門ガイドです。
Googleが軽量な埋め込みモデル「EmbeddingGemma 2」を公開。社内RAGを自社サーバーで動かす選択肢を解説します。
NVIDIA「DGX Spark」に64GBモデルが追加。価格は4,999ドルからで、2台接続すれば128GBまでメモリを拡張できます。
Ollama v0.35.0のプレリリースで追加された判定専用APIを解説。選択肢・確率・スコアを返す仕組みです。
OllamaがNVIDIAのNemotron Hによる画像認識をApple Silicon(MLX)で対応。v0.34.3のプレリリース版の変更点を解説しま…
ChatGPT DesktopからOllamaのローカルモデルを呼び出せる新機能を、公式ドキュメントをもとに解説します。
スポンサーリンク
古川渉一 著。自律型AIの基礎から導入・業務活用まで人気講師がやさしく解説。
要約・翻訳・コード補完の用途別に、Ollamaで試したい本命モデルをOllama公式ライブラリから整理しました。
Ollama公式ライブラリの人気順・タグの見方から、パソコンのスペックや用途に合わせた最初の1本の選び方までやさしく…
OllamaのモデルをClaude Desktop上で切り替えられる連携機能が、開発中の新版で見つかりました。
Ollama公式ドキュメントをもとに、対応GPUの条件とVRAM・RAMの必要スペックの目安をチェックリストで整理します。
ローカルLLMとクラウドAIは何が違う?データの扱い・オフライン動作という観点から公式情報をもとに整理し、向いてい…